
Connecter une intelligence artificielle à Make change la nature du travail d’automatisation. On ne se contente plus de déplacer des données d’une application à une autre : on délègue une partie du raisonnement à un modèle de langage, qui rédige, classe, résume ou décide à la place de l’utilisateur. Cette bascule change aussi la façon de construire un scénario, car une IA mal cadrée dans un flux automatisé peut produire des résultats incohérents, gonfler une facture ou bloquer tout le reste de la chaîne.
Comment Make s’articule avec les outils d’intelligence artificielle
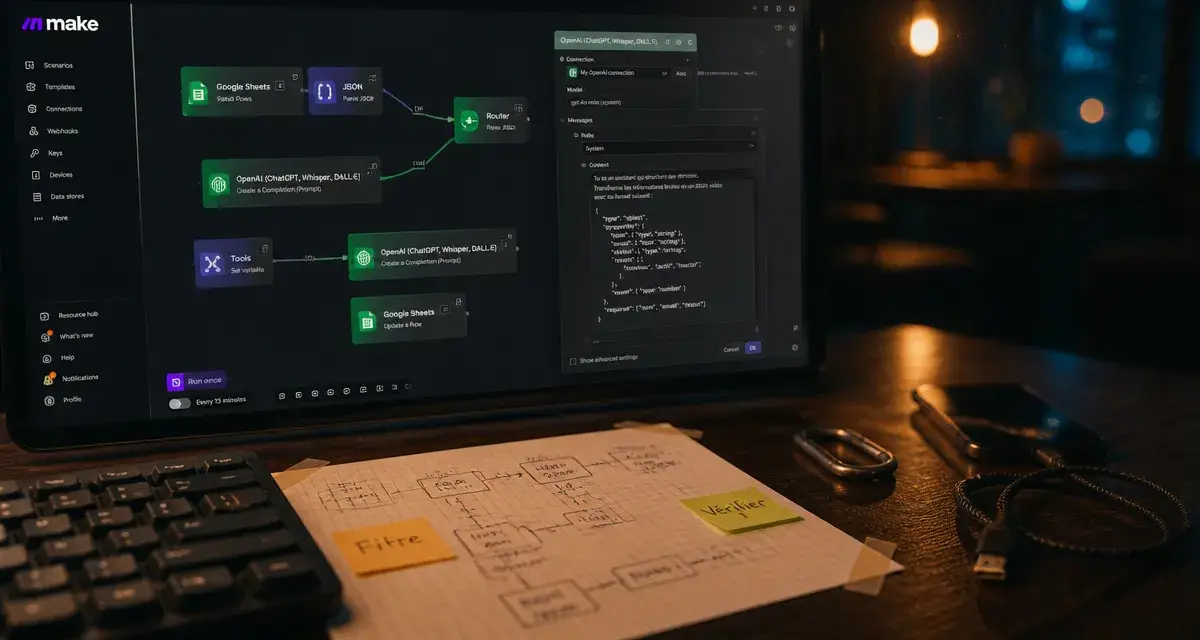
Make fonctionne par scénarios : une suite de modules reliés entre eux, chacun exécutant une action précise à partir des données reçues du module précédent. Intégrer une IA dans ce schéma revient simplement à insérer un module qui envoie un contenu à un modèle, récupère sa réponse, puis la transmet à la suite du scénario. La difficulté n’est pas technique, elle est méthodologique : il faut savoir quand appeler l’IA, avec quelles données, et ce qu’on fait de sa réponse.
Les modules IA natifs
Make propose des modules dédiés pour les principaux fournisseurs de modèles de langage, permettant d’envoyer un prompt, de fixer des paramètres comme la température ou la longueur de réponse, et de récupérer un texte structuré en sortie. Ces modules gèrent l’authentification et le formatage de la requête, ce qui évite d’écrire soi-même les appels HTTP. Ils conviennent parfaitement pour des tâches ponctuelles : rédiger un e-mail de relance, résumer un ticket client, classer un message entrant selon son intention.
Les webhooks et l’API pour les cas non couverts
Quand aucun module natif ne correspond à l’outil d’IA utilisé, Make permet de passer par un module HTTP générique ou par un webhook. Cette approche demande de connaître la structure de l’API cible (en-têtes, clé d’authentification, format du corps de requête), mais elle ouvre le champ à n’importe quel service, y compris des IA spécialisées ou hébergées en interne. C’est une option plus technique, à réserver aux scénarios où le module dédié ne suffit pas ou n’existe pas encore.
Construire un scénario IA de bout en bout
Un scénario qui fonctionne bien commence toujours par un déclencheur clair : une nouvelle ligne dans un tableur, un e-mail reçu, un formulaire soumis. C’est cette donnée d’entrée qui va nourrir le prompt envoyé à l’IA. Plus elle est propre et bien délimitée, plus la réponse du modèle sera exploitable directement, sans retouche manuelle.
Cadrer les données avant qu’elles n’atteignent l’IA
C’est là qu’intervient un réflexe trop souvent négligé : le filtre. Dans Make, un filtre placé entre deux modules ne sert pas seulement à éviter les erreurs, il sert de garde-fou avant l’appel à l’IA. On peut par exemple bloquer les enregistrements vides, écarter les doublons, ou ne laisser passer que les messages dépassant une certaine longueur avant de les envoyer à un modèle de résumé. Ce tri en amont a un double effet : il réduit le nombre d’appels facturés au fournisseur d’IA, et il améliore mécaniquement la qualité des réponses, car un modèle de langage traite toujours mieux une donnée homogène qu’un flux brut et hétérogène. Beaucoup de scénarios mal optimisés envoient tout à l’IA sans discernement, puis tentent de corriger la sortie a posteriori, alors qu’un filtrage en entrée règle le problème à la source.
Exploiter la réponse de l’IA dans la suite du scénario
Une fois la réponse obtenue, elle doit être découpée ou reformatée pour être utilisable par les modules suivants : extraction d’un champ précis, conversion en JSON, ou simple insertion dans un document. Il est utile de demander au modèle une sortie structurée dès le prompt, plutôt que du texte libre, pour limiter les erreurs d’interprétation lors du parsing automatisé.
Les erreurs courantes qui plombent les scénarios IA sur Make
La première erreur consiste à envoyer des prompts trop vagues, générés dynamiquement sans contrôle sur leur longueur ou leur contenu. Un prompt mal construit produit des réponses inconsistantes d’une exécution à l’autre, ce qui rend le scénario imprévisible. La seconde erreur, fréquente, est l’absence de gestion des erreurs de l’API : si le service d’IA répond une erreur ou un délai d’attente, le scénario entier peut s’arrêter sans notification, laissant l’utilisateur découvrir le problème bien plus tard.
La troisième erreur touche à la validation des sorties. Un modèle de langage peut renvoyer un format inattendu, un champ manquant, ou une réponse hors sujet. Sans étape de vérification avant l’action finale (envoi d’un e-mail, mise à jour d’une base), ces sorties imparfaites se propagent directement dans les outils métier, ce qui peut avoir des conséquences visibles pour les destinataires du scénario.
Maîtriser les coûts et les limites techniques
Chaque appel à un modèle d’IA a un coût, généralement calculé en fonction du volume de texte échangé, en entrée comme en sortie. Un scénario qui tourne sur un gros volume de données sans plafond peut rapidement générer une facture disproportionnée par rapport à sa valeur ajoutée. Il est recommandé de fixer des limites explicites : nombre maximal d’exécutions par jour, longueur maximale du texte envoyé, ou seuil de déclenchement pour n’appeler l’IA que sur les cas qui le justifient réellement.
Les quotas d’exécution de Make lui-même s’ajoutent à ceux du fournisseur d’IA. Un scénario qui dépend d’une IA lente peut consommer davantage de temps d’exécution que prévu, ce qui a un impact direct sur le nombre d’opérations disponibles dans le forfait. Surveiller régulièrement l’historique d’exécution permet de repérer les scénarios qui dérivent avant qu’ils ne deviennent coûteux.
Des cas d’usage concrets pour aller plus loin
Une fois la logique de base maîtrisée, plusieurs usages reviennent régulièrement chez les utilisateurs de Make. Le tri automatique des e-mails entrants selon leur intention, avec redirection vers la bonne équipe. La génération de comptes rendus à partir de notes brutes prises en réunion. La rédaction de premières versions de réponses client, ensuite validées par un humain avant envoi. Ou encore l’enrichissement de fiches produits à partir d’une simple description sommaire.
Dans tous ces cas, le principe reste le même : l’IA n’est qu’un module parmi d’autres dans le scénario, pas le pilote de l’ensemble. Elle donne le meilleur d’elle-même quand le flux qui l’entoure est propre, filtré et vérifié. C’est la logique d’automatisation de Make qui structure le résultat, pas l’IA elle-même.
Neuf ans à piloter une PME de 45 personnes, à tester des outils, à faire des erreurs — et à en tirer les leçons que personne ne publie. Aujourd’hui, je vous épargne les détours inutiles.